最近讀了 Anthropic 一篇關於何時應該將 subagents 整合回主 agent 的文章,最值得思考的一點是:
每增加一個 agent,都應該有一個可以驗證的理由。
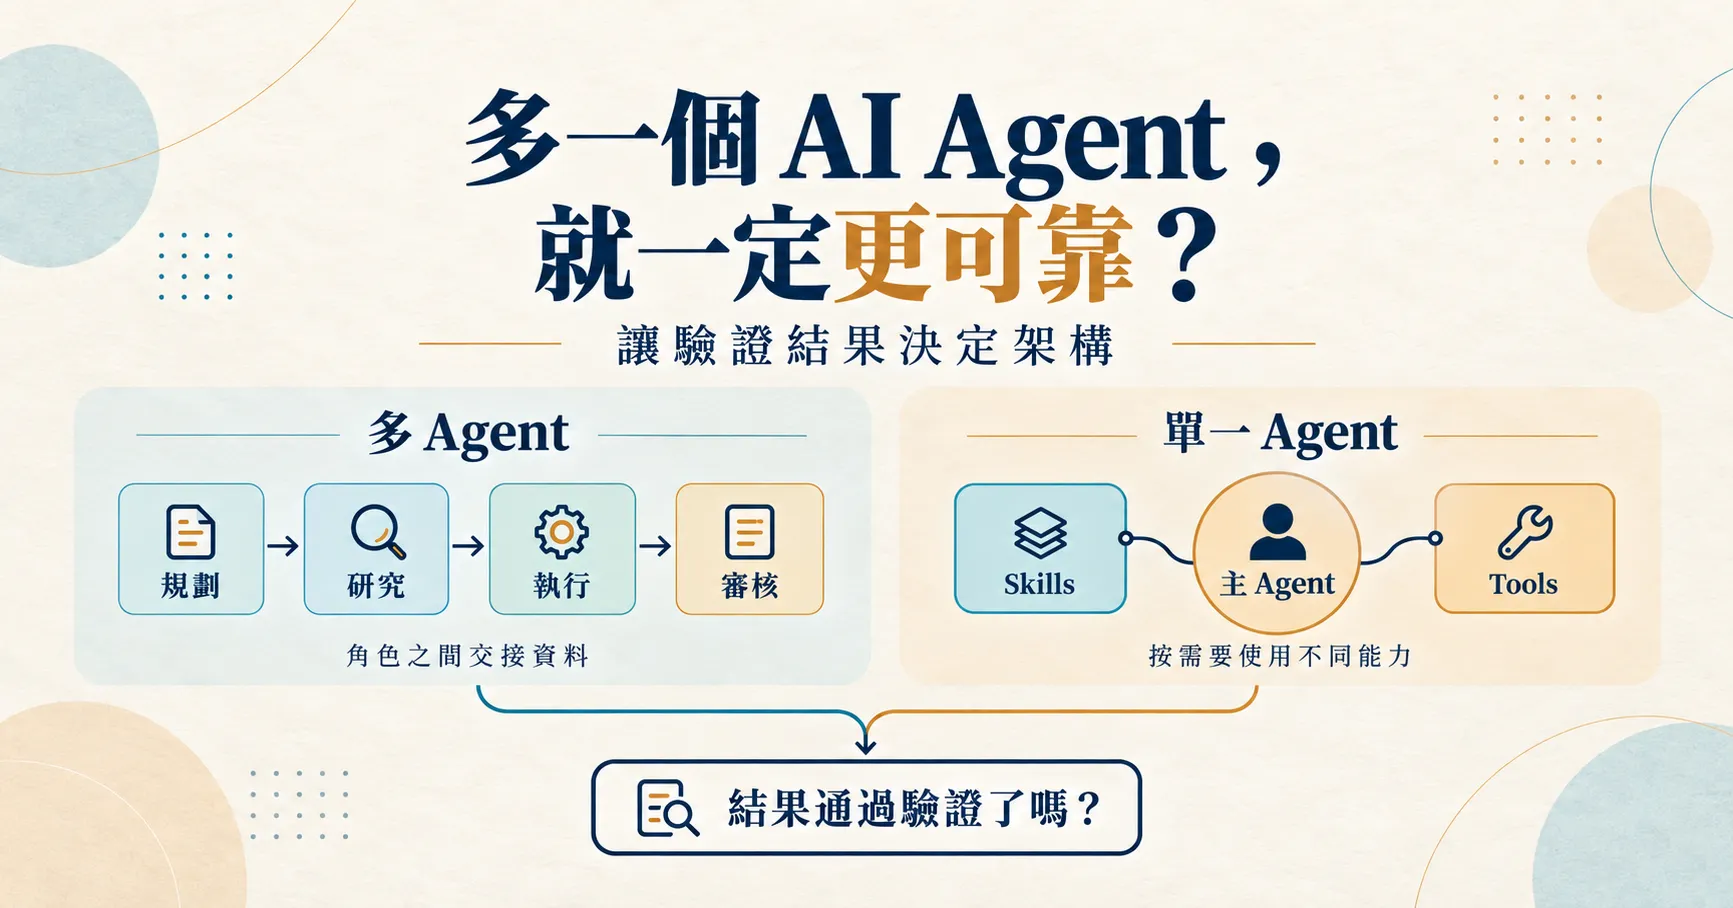
設計 AI 工作流程時,我們很容易先想到分工:一個 agent 負責規劃,一個負責研究,一個負責執行,再加一個負責審核。
架構看起來很完整,但多了這些角色,結果是否真的更好?
Anthropic 分享,在他們比較的部分企業部署中,單一 agent 配合 skills,經常能取得更好的品質,同時降低成本及延遲。這並不代表所有工作都適合交給單一 agent,而是提醒我們:架構的價值,需要透過實際結果來判斷。
先定義「做好」,再決定怎樣分工
以修復網站問題為例。
我們可以安排不同 agents 分別找出原因、修改程式及檢查結果。但在分工之前,更重要的是先定義:
- 能否重現原本的問題?
- 修改後,問題是否真正解決?
- 其他功能有沒有受到影響?
- 修改是否維持在要求的範圍內?
沒有這些檢查,我們可能只是在比較兩份寫得很有信心的報告,而不是兩個真正有效的解決方案。
假設結帳頁面的折扣計算有問題。Agent 修改了程式,現有測試也全部通過,但測試根本沒有涵蓋「多件商品同時使用折扣」的情況。
這時,即使加入另一個 agent 審核,它也可能根據同一批測試,得出「沒有問題」的結論。
流程多了一層,漏洞卻仍然存在。
審核需要具體證據
這也是我認為驗證機制值得更多關注的原因。
與其只要求 agent「幫我檢查一下」,不如給它明確的工作:
重現問題、檢查修改後的行為、嘗試相關邊界情況,以及指出哪些結論仍然缺乏證據。
在折扣計算的例子中,我會要求審核者測試不同購物組合,尤其是能觸發原本錯誤的情況,並列明哪些部分未能驗證。
另一個 agent 可以提供不同角度,但它需要有證據可以查核,也需要有空間提出異議。
衡量整個流程,而不只是單次成本
如果要決定是否保留這個審核 agent,我會用同一批問題,比較加入前後的結果:
- 成功修復了多少問題?
- 引入了多少新錯誤?
- 有多少次需要人手介入?
- 每次成功修復,總共花了多少時間及成本?
最後一項尤其重要。
一次執行比較便宜,但之後要花大量時間人手補救,整體成本未必更低。
平均分數也不是全部。我們還需要看清楚:哪些任務改善了?哪些原本能完成的任務,反而開始失敗?
讓架構隨證據演變
我的起點會是一個簡單、工具清晰、結果可以檢查的 agent。
當某項工作需要獨立驗證、可以平行處理,或確實受限於過多上下文時,再評估是否加入 subagent。
對已經運作中的多 agent 系統,我也會用同一標準決定是否整合,而不是單純追求減少數量。
在問「我需要多少個 agents?」之前,先問:「甚麼證據,會令我相信這項工作真的完成了?」
這個答案,往往比架構圖更值得先想清楚。
延伸閱讀:Anthropic — Building agents: When to fold subagents into your main agent loop